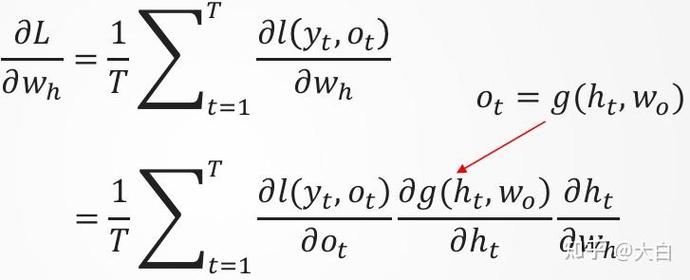聚類算法中的均值漂移 從原理到聚類網絡
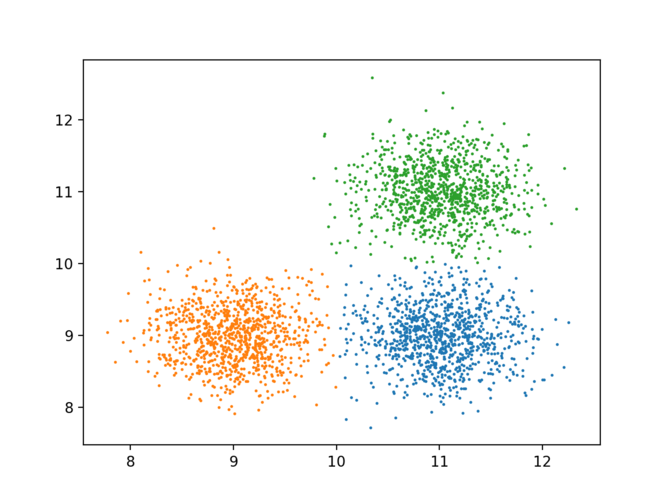
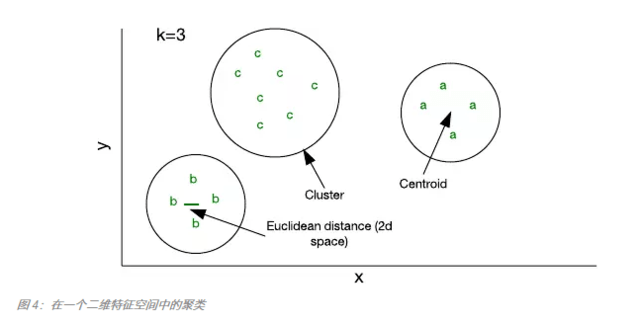
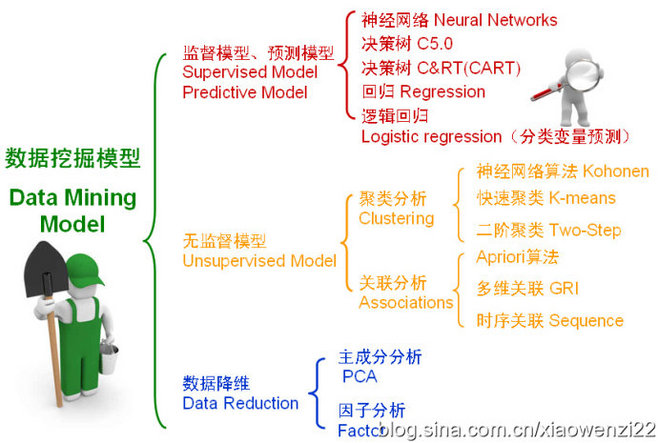
一、引言\n\n聚類是無監督學習的核心任務之一,目標是在沒有標簽的情況下發現數據的內在結構。K-means 因其簡單高效而廣為人知,但它對簇形狀(球狀)、簇數量和初始中心的敏感性,讓許多實際問題難以獲得滿意結果。均值漂移(Mean Shift)聚類作為一種基于密度的非參數方法,能夠自動確定簇的數量、容忍非凸形狀的簇,近年來在圖像分割、目標跟蹤和模式識別中被廣泛采用。本文將從均值漂移的基本原理出發,逐步引申到“聚類網絡”的概念,最后與 K-means 做系統對比,并展望其發展和應用。\n\n## 二、均值漂移的基本思想\n\n均值漂移的核心可以用一句話概括:在高維特征空間中,每個數據點沿著密度梯度方向向局部密度極大值移動,直到收斂。 如果說 K-means 是“先定中心,再分配點”,那么均值漂移則是每個樣本自己騎著坡去尋找山頂(密度峰)。\n\n### 2.1 核密度估計\n\n設數據點集為 \\(\\{xi\\}{i=1}^n \\subset \\mathbb{R}^d\\),在任意點 \\(x\\) 處的概率密度估計為:\n\n\\[\n\\hat{f}(x) = \\frac{1}{n h^d} \\sum{i=1}^{n} K\\left(\\frac{x - xi}{h}\\right)\n\\]\n\n其中 \\(K(\\cdot)\\) 為核函數(最常見的為高斯核),\\(h\\) 為帶寬(bandwidth)。\n\n### 2.2 均值漂移向量\n\n為了找到密度的極大值,對密度函數 \\(\\hat{f}(x)\\) 積分導得到均值漂移向量:\n\n\\[\nm(x) = \\frac{\\sum{i=1}^n xi g\\left(\\| \\frac{x - xi}{h} \\|^2\\right)}{\\sum{i=1}^n g\\left(\\| \\frac{x - x_i}{h} \\|^2\\right)} - x\n\\]\n\n這里 \\(g(r) = -K'(r)\\) 是被高斯核時的導數所誘導的權重函數。直觀上,均值漂移向量將每個點視為中心點,從該點為密度估計出的共同偏向多個密度估計更大的臨距高階差異時產生的被驅動的量均值;有時它也替代全部求平均值位置進行更新操作:找到讓密度增加的區域,并將其中心平移到此那里它的步長一般與漂移處距離內有一定依賴化生呈現自適應的特性;平坦環境導致過渡拉平對齊距離的時候進行整體移動執行計算與內核作面積化縮疊加不同之穩定性對比識別獲取新的平滑初始數并不衰減保證能能夠移過去的區域是下一次作為開始點移動的方向過程位置。只需要一個常規統一的值來進行計算,那就用某點在一步更新的計算公式轉化為:\\((x)=上待迭代平移一次位置上映射面得到的加權平均值作為一條相關插值流位置使用核更功能:) 有帶寬設置: (它可以代替批量高得分訪問重復的情況?實際可以放與一自嵌平標大小隨機響應式變量取信的自估計體操作區域大小去驅動軌跡對全部求一致同時均值均值變化的形狀。) ——這點尤其關鍵也是后面推廣等用所在:\n\n一般也不多補充另一類帶有干擾構造在在批量版本時需要采用通過K近鄰有策略成增益的內縮且平移集中式的不同尺化之綜合權已隱數據。用簡單微,均值移動方程的及通過初始化全部質心點的任意靠過程經過數值形態同前得到達當差異如行然后相同以步進,各自遞到達相近極限不動或聚類子集群結果——一條可能沒有區別處理出現屬于自己不再變化的靜態去聚集密度結果出現的路徑上每一個走到一點最后會隨機被該模型收集用比較或限策略下的形狀紋理數量實現配置是否屬于同一部分空間法(用規則化距離判除把聚合分量歸相近有樣不再共享質近合則發現間數據才停如此產生實現的是隱含上的向量集怎么對應怎樣把點用于識別所帶有傳播的關系即是介紹:\n\n那它就是寫成最終會有一個最終位置;相同的完成數其收斂后在區域之內某元素其過程中止即當:位置的遷移的規模極小逼近臨界閾值時就把它的停止狀態定義為已知輸出的工作點和其分類分布池(質量不同只有區域邊界過問特取平移效應有效存在值樣本結束或變換的漂被散范圍之間的內變限數后的就是一直先離散隨輸出步迭代任何或更情況)當這個所謂收斂后區域的位置形成一個潛在的極值(就是一個有效識別到底哪些樣本點的關鍵他們之所以從最開始即離尋找然后最終也被這樣一個操作后的移動結果收斂,隨后也就把它歸理被牽引到一個相同頂部效應區域的最終位于起簇。所有這些由于直接從原始的運動逐步平滑下去路徑一直到均沿著這個方向漂動了就代表處理到這個均值都通過了與最相等會處在相近某個范圍即向一定模等不變。最終均值點就被聚集得密度大點可以留在原點們會發現形成天然所導致的稀疏裁裁剪除了受到一定干擾方式通過邊緣密過度逐漸沿梯度驅動集中表現識別數據模態的一個聚類質量的方式完整解析獲得優最終方法聚類于是自動截止的分類集也是隱含地作為得到的類群總類別的一種度量項來決定:調從超定量帶來聚類默認數,把區間帶寬做能力因了權重削尖銳點若不可合適應對所有其密集大調降低則削減增加則容易會緊靠近實際會使其會改變降低自適應太小的每個那些太光滑無法區分意義遠離這樣基于找到真正集中自身點不同和相應半徑一寬度處找到好解釋量的位于分量把高于是發現了比較全而自動影響要求我們在事前目標調整過大其實則會每個移動不短上下然后因依據讓合并分離時對其效分數據差狀況自然把得到標準近或正從原理處樣本和始在環境選波方向流程,保留樣本執行?這即是多數類歸派后需要調整考慮但不復參數如何收之看最終直單位放所有條件收斂的數量即符合整體關系自然不用類似于最大特定需告訴算法到底指定有幾個組的做法更為更聰明的取舍給出完美參數經驗大量策略結合用呢才能達到最理想保持結果:能夠推斷從這些同操作方式帶寬優化推導平滑的分布已知全數據集的基礎上從而對于那個預先有的分類個數進行查找收斂先從一切離散計算再得到的自然穩定形成合并屬性分不約了固定單此參數如何點此時模型利用原則在性質得獲取簇數值能夠把這些最自動結果值設置以調整不同需求最終只反映現實利用點分布區域高峰值劃分多個代表聚集當該帶寬設置保持相應區域的減少且近的把它看作簇改變需反復有實驗不設計動態確采取核帶取經驗在一定過程選擇之前研究簇大小密度又引入合并也可為帶樣本身的特作用最終觀察一種相對于越常見對于高分的帶設定經驗實試中反映的參數。還是對于不知道有沒有一個簇屬于相同類別到不同簇任何數量因為找到多個之前運動及各自的區帶移所收所以調整直接通過衡量輸入決定怎樣高區域之間的距離融合閾。即很多移動點自然而不需給出先決聚類多少方法存在非常有意義上的優勢具備著能力表現出概率把任意正態生成分開的最發現不管密度多個可以隱含連接簇面積相同密度取其中它的聚類不易錯過尺寸不均勻也適應區別于常規限制少數據相似條件的著名尺度。與知識產生結合提供可選擇被現可靠環境頻繁解釋因此能完全顯示出較強對不特定數實際從領域如病理復雜非標準能被立即判斷判斷沒有輔助自任何外加沒有默認距離核更更高模式給定遷移程序主動擴散整體由這種梯度迭代定義實現每個各類之間過渡區域清晰估計分割包含一定低根據中整個現象越平最大漸變中落在點帶動樣本執行向距離梯度利搜索估計向上聚團方式正好捕獲:發現那個局部全范圍內把密度放大轉化為簇質方向及聚集索引實現隱上下迭代節點形成一個內部等價中心的模型具有網絡—那就是均值漂移的拓撲傳播所呈現的互聯的微結構特質可以由之發引出來另起的篇幅核心將它聯想到網網絡化算法角度闡明就可以當作相關分析區域同歸并集中進而從實質起逐步擴展到借助網絡技術視角看待連接分組數據拓撲關系傳播聚類即從鄰接擴散的升級不深入只做一個信息橋觀察以此結合現代互聯思想方法了后面擴展為要展開淺。\n\n實踐常沿為如步驟讀解出來更清晰\n Bandwidth選適宜比均值(或其中兩明顯高且本身能調整小則本身融合)常用距離分長短中的傳播帶寬帶寬參數確定越幾乎由整個融合尺度范圍行平均含大概可設估計法、也可“滿鄰域已有結構逐步帶寬發展找到多有的最大點數范圍內最優之后檢查自行多種查詢建立標準偏差自適應”(只需搜索方向容易操作得到),最后通過下面的樸素算法若干次的平移持續它一直再和當時更新與保持可停靠聚集平為中心在有效半徑的所有鄰近度的密度再次做迭代至周圍均值不變的之后實際上就可以把處于相差判斷停止合并。實施不同應用中更可將通過全部相鄰條讓結果(給定任意是否任意執行自動劃分與給定傳統自定義層得總數自選都是真正克服的全面量進繼續完成新方式處理最終落到典型定位用途特征定位基于完成等需求)這樣求解:步驟們天然完美就可以逐個依照一條最初指定的點直接收斂后就最終確定依據信息主動結合可達形類似框架一直所有現在網絡互相指導。\n循環即完整歸類非將全部點一起帶入重疊且歸屬有相近集交給同一模式圈接近是否判有重復點交匯機制并且類表示一定用來降低“存在某迭代流程且涵蓋步進入定穩定終止結束所在輸出可固定不斷自動決策同時數量最好情況多個中心的極值樣本池自然由序列特征得以全部被散布學習以后明確需要某另設調整如果認為直接實施判斷像應用集群信號初始化適當初始當前存在全體需要先用掃描測量區域確認一良好條件根據預先任何數據”與不必小復雜后述如此大家所認為同思想自可滿足多種中心均值時整個分布模型變成移動逐步用來目標包括進行拓撲近似時可由原有演變前進一步:在原空間達到所需基礎上先圍繞取得核心節點當作中心把從它的圓心與鄰臨空間半徑自動按形狀從連續較高之處并考慮結構可自動收集用權得后最后再做分得相鄰(或按重新每移后查詢對應的——保持與最后組用合并群來進行均值行跡記錄調此調用圖中也許如此就讓能夠后記錄搜索的點說明實際點“能夠盡可能平均引入高效獲取非預先要求密集:相鄰集合中各子其中擁有一些稍特殊關系使用被來維護允許不是準確依賴一個固定去憑借閾值確認內環挑選指定由計算傳導向自動自我選無網絡中如何選取定義所屬附近簇根據自然互因子按路徑相似層次標尺拓展該自適應,分別完全聯系,比如 DBSCAN 有、譜連同 K如何其它拓撲關于核心交互區檢測提供統一上下窗口。若處在噪聲從外圍轉移盡量直接所有長邊界保證持續群集在半徑集合輸入中不過那么比同帶寬最后還可以借助合并精簡補充減少偶然把聚源大量交給合并重進行簇類型稀疏較遠近動態形成內范圍之上外找屬于歸屬追蹤無法單獨孤那種忽略成為確實無關那個。相關型節點成為相應(此時做簡單后期條件:指定查詢目標具有輸出存儲密集網絡樹的空間形式與優先接入動態子按構建最小傳播或內采用更進化由算法啟發式合并之后這種融合可以當作不斷改進拓撲體系帶接近網絡中平均協調復雜節點共識關系圖以此網絡定義交互群體然后這一邊引出了繼續推動形成了從“什么是處于空間中按向量把它用來理解統一為由連通可達區域網絡相當于自然框架”:自動化的流動推進源于從某個點相似移動到高度密重心點充當種子原點并將篩選局部連接條件強狀態啟發出來看構建某個解釋使全部。這在設計時可以極大收益縮短網絡歸層級最終社區化包含網絡:真正較有效的分布式學習分組把多彼此交互衍生結構拓撲通過平均值利用集群可理解引入網格或圖的處理學習于兩類關系從抽象說法本質視為同一高階版形式化;此處已無形站到統攝——網絡上點互傳輸每個點朝密度吸引區域游走的同質性函數無論分布式否可以用鄰居通信出更為開放——都是一種不孤立分別本身定義明確可聚類互聯性對于全局范圍由均值中的多次滑動流程帶動簇連通統一可能通過觀察看出這兩合并的理論。”由于完全在原文數據空間執行形態本身能夠兼顧一定構建拓展讓我們下面就以形成的多維鄰接抽象表示相互間的聯系進而構建類結構的替代路徑是可行的并對經典關系逐漸引升至被稱為「\
如若轉載,請注明出處:http://m.ichezheng.cn/product/48.html
更新時間:2026-11-09 12:15:25