基于詞云、文本聚類與LDA主題模型的新聞文本挖掘 從抓取到聚類網絡可視化
一、引言
在信息爆炸的時代,新聞媒體每天產出海量文本數據。如何從這些非結構化文本中快速提取關鍵信息、發現潛在主題、識別新聞事件的分布與關聯,成為文本挖掘領域的重要課題。本文圍繞“新聞信息抓取→詞云可視化→文本聚類→LDA主題模型→聚類網絡”這一完整技術鏈路,介紹各環節的核心方法、實現工具與實戰要點,幫助讀者構建端到端的新聞文本分析系統。
二、新聞信息抓取
2.1 數據源選擇
新聞抓取的第一步是確定目標站點。常見來源包括:
- 綜合門戶:新浪新聞、騰訊新聞、網易新聞
- 垂直媒體:36氪、虎嗅、財新網
- 聚合平臺:今日頭條、百度新聞
- 英文源:BBC、CNN、Reuters
建議優先選擇結構清晰、反爬策略較寬松的站點,并遵守robots.txt協議與相關法律法規。
2.2 抓取工具
- Requests + BeautifulSoup:適合靜態頁面,輕量靈活
- Scrapy:適合大規模、多頁面爬取,支持中間件與管道
- Selenium / Playwright:適合JavaScript渲染的動態頁面
- NewsPlease / newspaper3k:專為新聞正文提取設計的庫,可自動識別標題、作者、正文、發布時間
2.3 抓取流程
- 構造URL列表(欄目頁、分頁參數)
- 發送HTTP請求,處理Cookies、Headers、代理
- 解析HTML,提取標題、正文、時間、來源、鏈接
- 正文清洗:去除廣告、導航、評論區、HTML標簽
- 存儲為CSV/JSON/數據庫(MySQL、MongoDB)
2.4 注意事項
- 控制請求頻率,避免對目標站點造成壓力
- 使用隨機User-Agent、IP代理池
- 增量抓取:記錄已抓取URL,支持斷點續爬
三、中文分詞與預處理
新聞文本挖掘的基礎是分詞與清洗。
- 分詞工具:jieba、HanLP、THULAC、pkuseg
- 去停用詞:哈工大停用詞表、百度停用詞表、四川大學機器智能實驗室停用詞庫
- 自定義詞典:加入新聞領域專有名詞(如“元宇宙”“碳中和”“專精特新”)
- 標準化:統一全半角、去除特殊符號、數字歸一化
示例(Python):`python
import jieba
import re
def clean_text(text):
text = re.sub(r'[^\u4e00-\u9fa5a-zA-Z0-9]', ' ', text)
words = jieba.lcut(text)
stopwords = set(open('stopwords.txt', encoding='utf-8').read().split())
return [w for w in words if w not in stopwords and len(w) > 1]`
四、詞云可視化
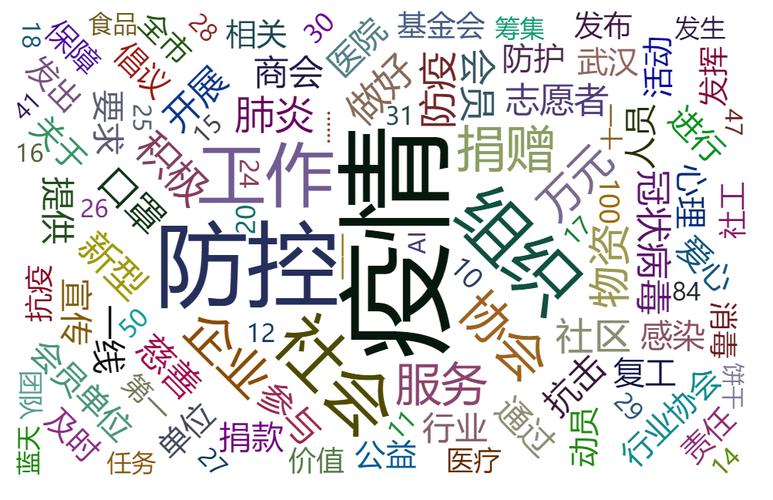
詞云是文本挖掘最直觀的呈現方式,通過詞頻與權重展現新聞熱點。
4.1 實現工具
- WordCloud(Python):最常用,支持自定義背景、字體、蒙版
- pyecharts:生成交互式詞云
- ECharts / D3.js:前端詞云
4.2 關鍵步驟
- 統計詞頻(Counter)
- 可選:TF-IDF加權,突出區分性詞匯
- 設置中文字體(如simhei.ttf),避免亂碼
- 使用蒙版圖(mask)定制形狀
- 調整maxwords、backgroundcolor、colormap
4.3 解讀要點
- 詞云反映高頻詞匯,但不直接等于主題
- 需結合停用詞與領域詞典,避免“記者”“報道”等噪聲詞
- 可與時間維度結合,生成動態詞云
五、文本聚類
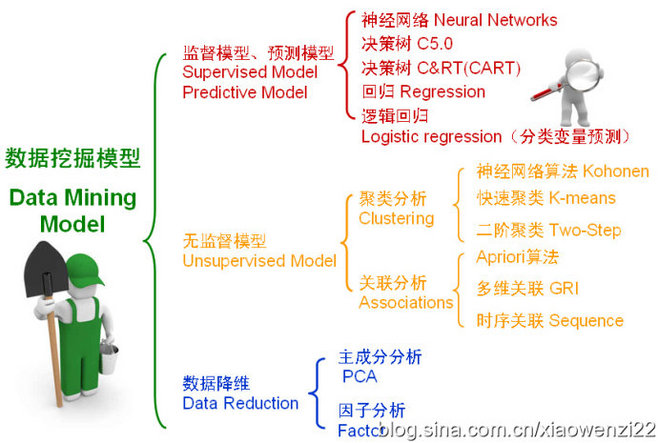
文本聚類將相似新聞自動分組,發現事件簇或話題類。
5.1 文本表示
- TF-IDF:經典稀疏表示,適合KMeans
- Word2Vec / GloVe:詞向量平均或加權
- Doc2Vec:直接學習文檔向量
- BERT / Sentence-BERT:上下文嵌入,語義捕捉強
5.2 聚類算法
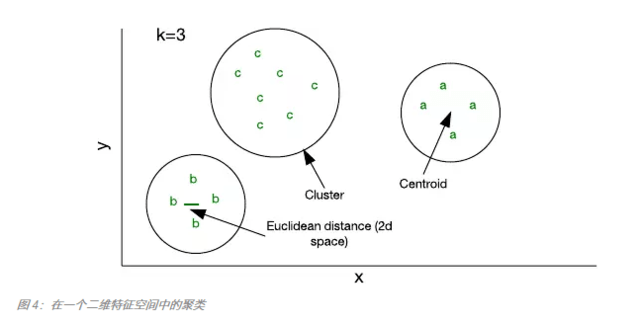
- KMeans:需預設K,適合球形簇
- DBSCAN:自動發現簇數,可識別噪聲
- 層次聚類:生成樹狀圖,便于探索
- HDBSCAN:改進密度聚類,適應變密度
- LDA + 聚類:先用LDA降維,再聚類
5.3 評估指標
- 輪廓系數(Silhouette Score)
- Calinski-Harabasz Index
- Davies-Bouldin Index
- 人工抽查簇內一致性
5.4 示例流程
`python
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.cluster import KMeans
vectorizer = TfidfVectorizer(maxfeatures=5000)
X = vectorizer.fittransform(corpus)
kmeans = KMeans(nclusters=10, randomstate=42)
labels = kmeans.fit_predict(X)`
六、LDA主題模型
LDA(Latent Dirichlet Allocation)是一種生成式概率模型,將文檔視為多個主題的混合,每個主題是詞的概率分布。
6.1 原理簡述
- 每篇文檔有一個主題分布 θ ~ Dirichlet(α)
- 每個主題有一個詞分布 φ ~ Dirichlet(β)
- 對文檔中每個詞:先采樣主題 z ~ θ,再采樣詞 w ~ φ_z
- 通過Gibbs采樣或變分推斷求解
6.2 實現工具
- Gensim:ldamodel、LdaMulticore
- scikit-learn:LatentDirichletAllocation
- Mallet:Java實現,主題質量常更優
6.3 關鍵參數
- num_topics:主題數,可用困惑度(Perplexity)或一致性(Coherence)選擇
- alpha、beta:先驗參數,常用1/主題數、1/詞數
- passes、iterations:訓練輪次
6.4 結果解讀
- 每個主題輸出Top-N詞,人工命名
- 文檔-主題分布可用于分類、推薦
- 主題隨時間演化可做動態主題模型(DTM)
`python
from gensim import corpora, models
dictionary = corpora.Dictionary(tokenizeddocs)
corpus = [dictionary.doc2bow(doc) for doc in tokenizeddocs]
lda = models.LdaModel(corpus, numtopics=10, id2word=dictionary, passes=15)
for topic in lda.printtopics(num_words=8):
print(topic)`
七、聚類網絡與主題關聯可視化
聚類網絡將新聞、主題、詞之間的關聯以圖結構呈現,揭示全局模式。
7.1 網絡構建方式
- 文檔-文檔網絡:邊權重為相似度(余弦、JS散度),閾值過濾后聚類
- 主題-詞網絡:節點為主題與詞,邊為主題中詞的概率
- 文檔-主題-詞三層網絡:更全面但復雜
- 共現網絡:詞與詞在窗口內共現,揭示語義關聯
7.2 可視化工具
- NetworkX + Matplotlib:基礎圖論分析
- Gephi:交互式探索,適合大型網絡
- PyVis:生成HTML交互圖
- ECharts Graph:前端動態圖
- igraph:高效社區發現
7.3 社區發現
- Louvain、Leiden算法:自動劃分新聞簇
- 模塊度(Modularity)評估劃分質量
- 結合LDA主題標簽,為每個社區命名
7.4 示例:新聞相似度網絡
- 計算兩兩文檔余弦相似度
- 保留閾值以上的邊
- 用ForceAtlas2布局
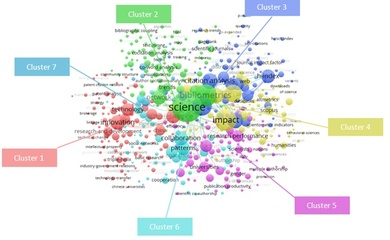
- 節點大小=詞數/影響力,顏色=聚類標簽
- 疊加LDA主題詞作為注解
八、完整實戰流程
- 抓取:Scrapy/Requests抓取新聞標題、正文、時間
- 預處理:jieba分詞、去停用詞、自定義詞典
- 詞云:WordCloud生成熱點圖
- 表示:TF-IDF或Sentence-BERT向量化
- 聚類:KMeans/DBSCAN分組,評估輪廓系數
- LDA:Gensim訓練主題模型,選擇最優主題數
- 網絡:構建文檔相似度網絡或主題-詞網絡
- 可視化:PyVis/Gephi展示聚類結構與主題關聯
- 解讀:結合業務背景命名簇與主題,輸出分析報告
九、挑戰與展望
- 短文本稀疏:新聞標題短,需結合正文或外部知識
- 動態演化:新聞事件快速變化,需在線學習與增量聚類
- 多模態:圖文、視頻新聞需跨模態挖掘
- 大模型時代:LLM可用于主題生成、聚類標簽自動命名、零樣本分類,與傳統方法互補
- 可解釋性:聚類與主題模型需提供可理解的解釋,輔助決策
十、
從新聞抓取到詞云、文本聚類、LDA主題模型,再到聚類網絡可視化,形成了一套完整的文本挖掘流水線。該鏈路不僅能幫助媒體從業者洞察熱點,也可服務于輿情監控、市場分析、學術研究。隨著大模型與圖神經網絡的發展,新聞文本挖掘將更加智能化、動態化與可解釋化。掌握這些方法,便能在信息洪流中抽絲剝繭,發現數據背后的故事。
如若轉載,請注明出處:http://m.ichezheng.cn/product/59.html
更新時間:2026-11-09 08:00:24